En bref
- Fabriquer une IA moderne demande trois ressources : des données, de la puissance de calcul (GPU) et des équipes de chercheurs et d’ingénieurs.
- Le processus suit des étapes précises : collecte et nettoyage des données, pré-entraînement, réglage fin, alignement sur les préférences humaines, évaluation, puis déploiement.
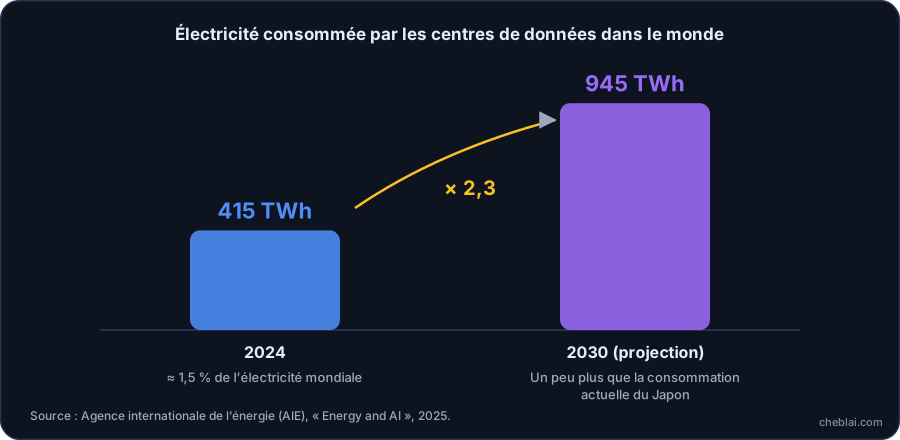
- Le coût est considérable pour les plus grands modèles, et l’électricité consommée par les centres de données, selon l’Agence internationale de l’énergie, pourrait plus que doubler d’ici 2030.
Sur cette page
Vue d’ensemble : le cycle de vie d’un modèle d’IA
Créer un assistant comme ChatGPT, Claude, Gemini ou Mistral ne consiste pas à « programmer » une intelligence. C’est un projet industriel en plusieurs étapes, qui mobilise des centaines de personnes et des infrastructures gigantesques.
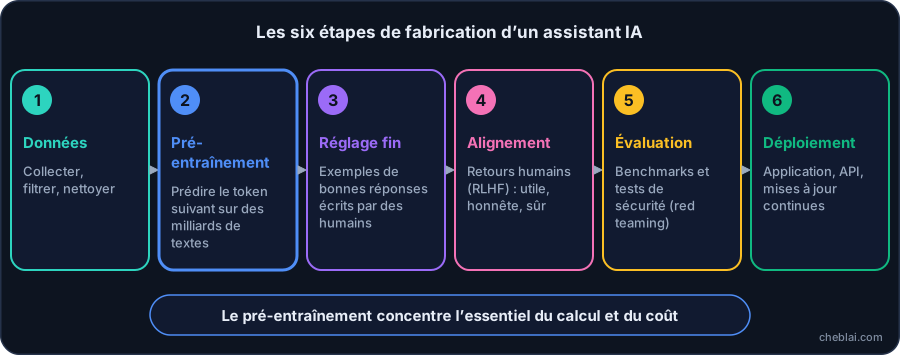
Détaillons chaque étape.
Étape 1 : rassembler et préparer les données
Un modèle de langage est entraîné sur des volumes de texte énormes. Pour GPT-3 (2020), le modèle a été entraîné sur environ 300 milliards de « tokens », tirés d’un corpus d’environ 500 milliards ; plus de la moitié provenait de Common Crawl, une copie publique d’une grande partie du web, complétée par des livres, des pages de Wikipédia et d’autres corpus.
Mais les données brutes ne peuvent pas être utilisées telles quelles. Il faut :
- filtrer les contenus de mauvaise qualité, les doublons, les spams ;
- retirer autant que possible les informations personnelles et les contenus illicites ;
- équilibrer les sources et les langues ;
- respecter le droit : l’utilisation d’œuvres protégées pour entraîner des IA fait l’objet de plusieurs procès, par exemple celui du New York Times contre OpenAI et Microsoft, ouvert en décembre 2023.
Étape 2 : le pré-entraînement, la phase la plus lourde
Le modèle apprend à prédire le prochain token sur l’ensemble du corpus. C’est l’étape la plus gourmande en calcul, et celle qui donne au modèle ses connaissances générales de langue et de culture.
Elle repose sur des GPU (graphics processing units), des processeurs conçus à l’origine pour les jeux vidéo et capables d’effectuer des milliers de petits calculs en parallèle, ce qui convient parfaitement aux réseaux de neurones. AlexNet, en 2012, tenait sur deux cartes graphiques grand public. Aujourd’hui, un grand modèle mobilise des dizaines de milliers de GPU dans des centres de données, pendant des semaines ou des mois.
Selon les ordres de grandeur publiés dans la littérature (qui sont des estimations, les entreprises ne dévoilant pas toujours leurs coûts réels) : environ 50 000 dollars pour GPT-2 (2019), environ 8 millions pour PaLM (2022), et des centaines de millions de dollars pour les plus grands modèles récents. DeepSeek a affirmé en janvier 2025 avoir entraîné son modèle V3 pour environ 5,6 millions de dollars de calcul, un chiffre qui ne couvre selon les observateurs qu’une partie du coût total.
Des « lois d’échelle » observées par les chercheurs montrent que les performances s’améliorent de façon régulière quand on augmente à la fois la taille du modèle, la quantité de données et la puissance de calcul. Ces observations, publiées notamment par OpenAI (2020) puis par DeepMind avec le modèle Chinchilla (2022), ont guidé la course à la taille.
Étapes 3 et 4 : réglage fin et alignement
À la fin du pré-entraînement, le modèle sait « continuer un texte », mais ce n’est pas encore un assistant : si vous lui posez une question, il peut répondre par une autre question, ou continuer comme un texte de forum. Deux étapes le rendent utile et sûr :
- Le réglage fin supervisé (fine-tuning) : on le réentraîne sur des milliers à des dizaines de milliers d’exemples de bonnes conversations, rédigés par des humains.
- L’alignement, notamment par RLHF (apprentissage par renforcement avec retour humain) : des évaluateurs classent des réponses ; le modèle est ajusté pour produire des réponses plus utiles, honnêtes et inoffensives. Certains laboratoires ajoutent des principes écrits (IA constitutionnelle, chez Anthropic).
Ces étapes sont bien moins coûteuses que le pré-entraînement, mais décisives pour la qualité perçue de l’assistant.
Étape 5 : l’évaluation et les tests de sécurité
Avant de publier un modèle, les équipes le soumettent à des benchmarks : des batteries de tests standardisés (mathématiques, code, connaissances générales, compréhension de textes…). Elles organisent aussi du red teaming : des experts essaient volontairement de le piéger pour trouver ses failles (réponses dangereuses, fuites de données, biais).
Étape 6 : le déploiement et l’amélioration continue
Le modèle est ensuite mis à disposition : via un site de chat, une application, ou une API que les développeurs intègrent à leurs logiciels. Chaque réponse demande de la puissance de calcul (l’inférence), ce qui explique pourquoi certains services sont payants ou limités en nombre de requêtes.
Une fois en service, les éditeurs surveillent les usages, corrigent les défauts et publient de nouvelles versions régulièrement. Certaines entreprises publient les « poids » de leurs modèles, qu’on peut alors télécharger et faire tourner soi-même : on parle de modèles ouverts (open weights), comme ceux de Mistral AI ou DeepSeek. D’autres gardent leurs modèles fermés et ne les proposent que via leurs services.
Le coût énergétique et environnemental
Les centres de données consomment de l’électricité pour entraîner les modèles, mais aussi pour répondre aux millions de requêtes quotidiennes. D’après l’Agence internationale de l’énergie (AIE), les centres de données ont consommé environ 415 TWh en 2024, soit environ 1,5 % de l’électricité mondiale. L’AIE projette un doublement, à environ 945 TWh en 2030, l’IA étant l’un des principaux moteurs de cette hausse.
L’impact varie fortement selon l’énergie utilisée, le refroidissement et l’efficacité des modèles. Les chercheurs travaillent à réduire ce coût : modèles plus petits, puces plus efficaces, techniques de compression. Pour l’utilisateur, des gestes simples existent : choisir un modèle adapté à sa tâche plutôt que le plus gros, et éviter les requêtes inutiles.
Qui fabrique les IA ?
Le développement des plus grands modèles est dominé par quelques acteurs : OpenAI (fondée en décembre 2015), Google DeepMind, Anthropic (fondée en 2021), Meta, Mistral AI (France, 2023), DeepSeek (Chine, 2023) et d’autres. Selon l’AI Index 2026 de Stanford, plus de 90 % des modèles notables proviennent de l’industrie plutôt que du monde académique, et les États-Unis comme la Chine y jouent un rôle majeur.
Vous pouvez découvrir et comparer les assistants issus de ces acteurs dans notre annuaire d’outils IA, par exemple ChatGPT, Claude, Gemini ou Mistral Le Chat.
Questions fréquentes
Comment crée-t-on une intelligence artificielle ?
On rassemble de grandes quantités de données, on entraîne un réseau de neurones dessus avec de la puissance de calcul (GPU), on l’affine avec des exemples humains puis des retours humains, on l’évalue, et enfin on le déploie via une application ou une API.
Combien coûte l’entraînement d’une IA ?
Cela varie énormément : de quelques milliers de dollars pour un petit modèle à des centaines de millions pour les plus grands. À titre d’ordre de grandeur publié, environ 50 000 dollars pour GPT-2 (2019) et environ 8 millions pour PaLM (2022). Les chiffres réels des modèles récents sont rarement publics.
Pourquoi utilise-t-on des GPU pour l’IA ?
Parce que ces processeurs, conçus pour le graphisme, peuvent effectuer des milliers de calculs simultanément. Or l’entraînement d’un réseau de neurones consiste en une multitude d’opérations similaires, parfaitement adaptées au calcul parallèle.
Peut-on créer sa propre IA ?
Oui, à petite échelle. On peut entraîner un petit modèle sur ses propres données, ou plus simplement adapter un modèle ouvert existant (réglage fin) sur un ordinateur ou un service cloud. Entraîner un très grand modèle à partir de zéro reste réservé à des organisations disposant de moyens considérables.
L’IA consomme-t-elle beaucoup d’électricité ?
Collectivement, oui : selon l’AIE, les centres de données représentaient environ 1,5 % de l’électricité mondiale en 2024 (415 TWh) et pourraient atteindre environ 945 TWh en 2030. Une seule requête consomme peu, mais le total est élevé avec des millions d’utilisateurs.
Sources et références
- AIE — Energy and AI (2025)
- Stanford HAI — AI Index Report 2026
- Wikipedia — GPT-3
- Wikipedia — Large language model (coûts d’entraînement et lois d’échelle)
- Wikipedia — DeepSeek
- Hoffmann et al. (DeepMind), « Training Compute-Optimal Large Language Models » (Chinchilla), 2022
- Kaplan et al. (OpenAI), « Scaling Laws for Neural Language Models », 2020