En bref
- ChatGPT, Claude ou Gemini sont des grands modèles de langage (LLM) : ils génèrent du texte en prédisant, token après token, la suite la plus probable d’une phrase.
- Leur force vient de l’architecture Transformer (2017) et de son mécanisme d’attention, qui permet de relier chaque mot à tous les autres mots du contexte.
- Parce qu’ils prédisent du texte plausible plutôt que de vérifier des faits, ils peuvent produire des « hallucinations » : des réponses fausses énoncées avec assurance.
Sur cette page
Le principe : prédire le mot suivant
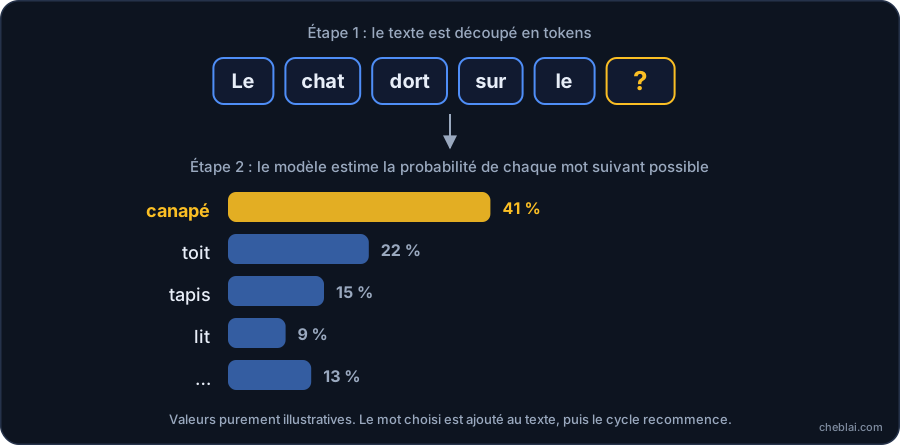
Un grand modèle de langage (LLM, large language model) est un réseau de neurones entraîné sur une quantité colossale de textes avec un objectif unique en apparence modeste : prédire ce qui vient ensuite. Si on lui donne « Le chat dort sur le », il estime la probabilité de chaque mot possible pour la suite (« canapé », « toit », « tapis »…), puis en choisit un.
On ajoute ensuite le mot choisi à la phrase, et on recommence : c’est de cette répétition que naissent des paragraphes entiers. Tout ce que vous voyez, une réponse, un poème, un programme informatique, est produit un petit morceau à la fois.
Les tokens : comment une machine lit du texte
Un ordinateur ne comprend que des nombres. Le texte est donc d’abord découpé en petits morceaux appelés tokens, qui peuvent être des mots entiers, des parties de mots ou des signes de ponctuation. Chaque token reçoit un numéro dans un vocabulaire de plusieurs dizaines de milliers d’entrées.
Chaque token est ensuite transformé en une longue liste de nombres appelée embedding (plongement). Ces nombres positionnent le mot dans une sorte de carte du sens : des mots proches (« chien » et « chat ») se retrouvent à des endroits voisins. Cette idée a été popularisée par word2vec (Tomas Mikolov, Google, 2013).
En pratique, un token représente environ trois quarts d’un mot en anglais ; le français, le chinois et d’autres langues demandent généralement plus de tokens pour un même texte. Les modèles facturent et limitent leur usage en tokens.
Le Transformer et l’attention : le moteur des LLM
Avant 2017, les modèles de langage lisaient les phrases mot après mot, avec une mémoire limitée. Le 12 juin 2017, huit chercheurs de Google ont publié « Attention Is All You Need », qui présente l’architecture Transformer.
Son idée centrale est le mécanisme d’attention : pour comprendre un mot, le modèle regarde tous les autres mots du contexte et décide lesquels comptent le plus. Dans « La banque a refusé le prêt parce qu’elle était prudente », l’attention aide à relier « elle » à « banque » plutôt qu’à « prêt ».
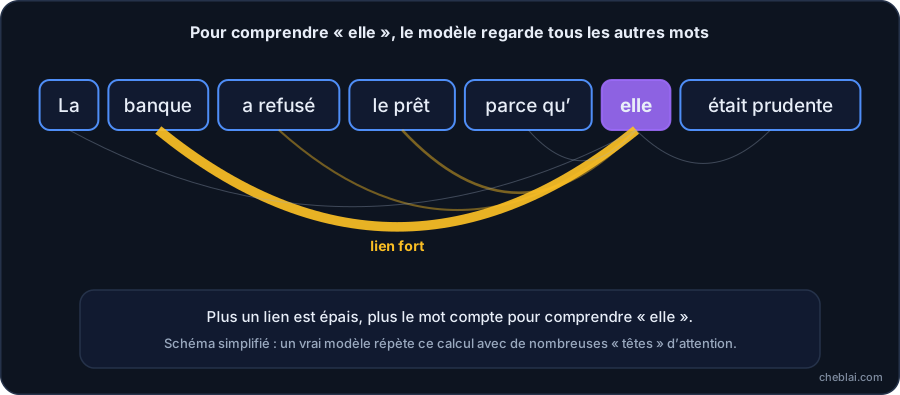
Deux avantages expliquent le succès de cette architecture. D’abord, elle traite tous les mots en parallèle, ce qui exploite à plein les GPU et permet d’entraîner des modèles bien plus gros. Ensuite, elle gère bien les longues dépendances : relier un mot au début d’un texte avec un mot situé beaucoup plus loin. Cet article a été cité plus de 250 000 fois et figure parmi les plus cités du XXIᵉ siècle.
La fenêtre de contexte : la mémoire de travail du modèle
Un modèle ne peut « voir » qu’une quantité limitée de texte à la fois : sa fenêtre de contexte. Elle comprend votre question, l’historique de la conversation et la réponse en cours. GPT-3 (2020) était limité à 2 048 tokens, soit quelques pages ; les modèles récents acceptent beaucoup plus, jusqu’à des centaines de milliers de tokens (des livres entiers) pour certains.
Au-delà de cette fenêtre, le modèle « oublie » ce qui précède. Il n’a pas de mémoire permanente de vos discussions, sauf si l’outil ajoute une fonction de mémoire distincte.
Du modèle de langage à l’assistant
Un modèle pré-entraîné seul se contente de continuer un texte. Pour en faire un assistant, on lui apprend à suivre des instructions (réglage fin) puis à privilégier les réponses jugées utiles par des humains (RLHF), comme expliqué dans comment une IA apprend. ChatGPT a été lancé le 30 novembre 2022 sur la base de GPT-3.5, entraîné de cette façon.
Aujourd’hui, les assistants ajoutent des capacités par-dessus le modèle de base :
- La recherche web : l’assistant interroge un moteur de recherche et cite des sources (c’est le principe de Perplexity AI).
- Les outils : exécuter du code, analyser un fichier, calculer, appeler une application.
- La multimodalité : comprendre et produire des images, du son, voire de la vidéo.
- Le raisonnement : certains modèles « réfléchissent » plus longtemps avant de répondre, en produisant des étapes intermédiaires, ce qui améliore les résultats sur les problèmes complexes.
Pourquoi ChatGPT se trompe parfois : les hallucinations
Une hallucination est une réponse qui semble fluide et crédible, mais qui est fausse ou inventée. Elle découle directement du fonctionnement décrit plus haut : le modèle est entraîné à produire un texte plausible, pas à vérifier un fait. Quand il lui manque une information, il peut combler le vide avec une réponse vraisemblable.
Ce n’est pas anecdotique. En 2023, deux avocats américains ont déposé devant un tribunal fédéral de New York des décisions de justice inventées par ChatGPT (affaire Mata v. Avianca) ; le juge a prononcé une sanction de 5 000 dollars. En février 2024, un tribunal canadien a jugé Air Canada responsable des informations erronées données par son chatbot sur un tarif de deuil.
Les principaux assistants actuels
Plusieurs familles de modèles se partagent le marché. Elles évoluent vite ; voici les principales, avec leurs éditeurs :
| Assistant | Éditeur | Particularité |
|---|---|---|
| ChatGPT | OpenAI (États-Unis) | Le plus connu ; 900 millions d’utilisateurs hebdomadaires annoncés début 2026 |
| Claude | Anthropic (États-Unis) | Fondé sur l’« IA constitutionnelle » ; apprécié pour les longs textes et le code |
| Gemini | Intégré aux services Google ; multimodal | |
| Mistral Le Chat | Mistral AI (France) | Acteur européen, avec des modèles ouverts |
| Perplexity AI | Perplexity | Moteur de réponses qui cite ses sources |
Pour comparer plus précisément, utilisez notre comparateur ou parcourez l’annuaire. Le guide du débutant explique comment choisir.
Questions fréquentes
Comment fonctionne ChatGPT en termes simples ?
ChatGPT est un grand modèle de langage : un réseau de neurones entraîné à prédire le mot (ou token) suivant dans un texte. En répétant cette prédiction mot après mot, il produit des réponses entières. Il a ensuite été affiné avec des exemples et des retours humains pour se comporter comme un assistant.
Qu’est-ce qu’un token ?
Un token est un petit morceau de texte (un mot, une partie de mot ou un signe de ponctuation) transformé en nombre pour que le modèle puisse le traiter. En français, un mot compte souvent un ou deux tokens.
Qu’est-ce que l’architecture Transformer ?
C’est une architecture de réseau de neurones publiée par des chercheurs de Google le 12 juin 2017. Elle utilise un mécanisme d’attention qui relie chaque mot à tous les autres mots du contexte et traite le texte en parallèle. Elle est à la base de la plupart des grands modèles de langage.
Pourquoi ChatGPT invente-t-il des informations ?
Parce qu’il est conçu pour produire du texte plausible, pas pour vérifier des faits. Quand il manque d’information, il peut générer une réponse vraisemblable mais fausse : c’est ce qu’on appelle une hallucination. Il faut donc vérifier les informations importantes.
ChatGPT a-t-il accès à Internet ?
Le modèle lui-même ne consulte pas Internet : ses connaissances s’arrêtent à une date d’entraînement. Mais ChatGPT et d’autres assistants peuvent être équipés d’une fonction de recherche web qui leur permet de chercher des informations récentes et de citer des sources.
Sources et références
- Vaswani et al., « Attention Is All You Need », arXiv, 2017
- Wikipedia — Large language model
- Wikipedia — ChatGPT
- Wikipedia — Hallucination (artificial intelligence)
- Wikipedia — Mata v. Avianca, Inc.
- Mikolov et al., « Efficient Estimation of Word Representations in Vector Space » (word2vec), 2013
- Brown et al. (OpenAI), « Language Models are Few-Shot Learners » (GPT-3), 2020