En bref
- Une IA apprend en répétant une boucle : elle fait une prédiction, mesure son erreur, puis corrige légèrement ses paramètres. Des milliards de répétitions plus tard, l’erreur devient faible.
- Il existe trois grandes manières d’apprendre : avec des exemples corrigés (supervisé), en trouvant seule des structures (non supervisé), ou par essais et récompenses (par renforcement).
- Les assistants comme ChatGPT combinent plusieurs méthodes : prédire le mot suivant sur d’énormes volumes de texte, puis être affinés avec des retours humains (RLHF).
Sur cette page
La boucle d’apprentissage : prédire, mesurer l’erreur, corriger
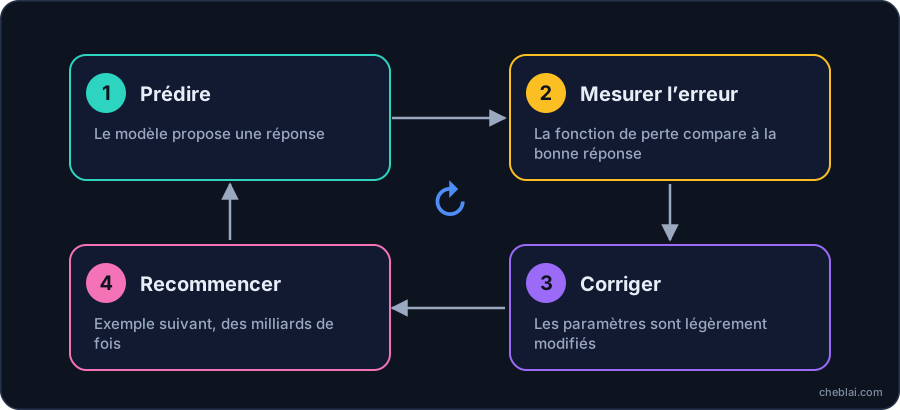
Quelle que soit la méthode, apprendre revient presque toujours à répéter les mêmes quatre étapes, des millions ou des milliards de fois.
- Prédire
Le modèle reçoit une donnée (une photo, une phrase tronquée) et propose une réponse. Au début, ses paramètres sont aléatoires : la réponse est absurde.
- Mesurer l’erreur
On compare sa réponse à la bonne réponse grâce à une fonction de perte, un nombre qui indique « à quel point le modèle se trompe ».
- Corriger
Un algorithme calcule dans quel sens et de combien modifier chaque paramètre pour réduire l’erreur. Cette correction se fait par la descente de gradient et la rétropropagation, expliquées plus bas.
- Recommencer
On passe à l’exemple suivant. L’erreur diminue progressivement.
La descente de gradient : redescendre une montagne dans le brouillard
Imaginez que vous êtes perdu dans le brouillard sur une montagne et que vous voulez rejoindre la vallée. Vous ne voyez pas le paysage, mais vous sentez la pente sous vos pieds. À chaque pas, vous avancez un peu dans la direction qui descend le plus. C’est exactement ce que fait la descente de gradient : l’altitude représente l’erreur, et chaque pas ajuste les paramètres pour la réduire.
Le calcul de la « pente » pour chacun des milliards de paramètres est réalisé efficacement par la rétropropagation du gradient (backpropagation). Cette méthode, popularisée en 1986 par David Rumelhart, Geoffrey Hinton et Ronald Williams, remonte du résultat final vers les premières couches pour déterminer la responsabilité de chaque paramètre dans l’erreur.
Trois grandes façons d’apprendre
1. L’apprentissage supervisé : apprendre avec un professeur
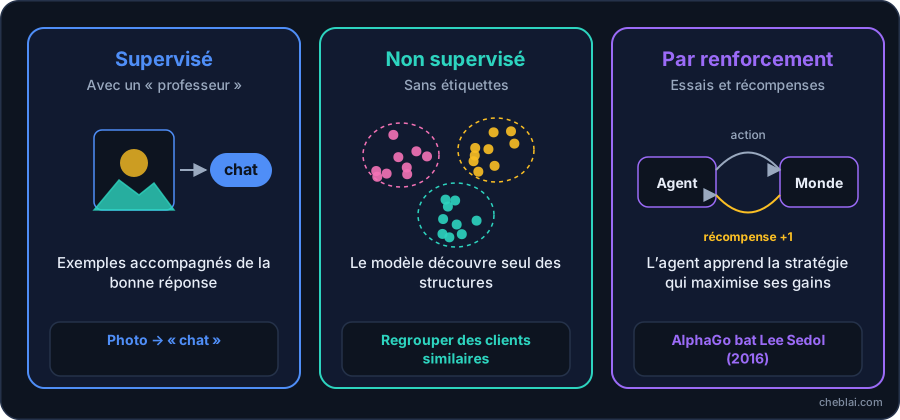
On fournit au modèle des exemples étiquetés : « cette image est un chat », « ce mail est un spam », « cette radio montre une tumeur ». Le modèle apprend à retrouver l’étiquette. C’est la méthode derrière la reconnaissance d’images (comme AlexNet en 2012 avec la base ImageNet), les filtres antispam ou la détection de fraude bancaire. Son point faible : il faut beaucoup d’exemples corrects, souvent annotés par des humains.
2. L’apprentissage non supervisé et auto-supervisé : apprendre sans étiquettes
Ici, on ne donne aucune « bonne réponse ». Le modèle doit découvrir seul des structures : regrouper des clients aux comportements proches, par exemple. Une variante essentielle, l’apprentissage auto-supervisé, fabrique ses propres exercices à partir des données brutes : on cache un mot dans une phrase, et le modèle doit le deviner. C’est ainsi que les grands modèles de langage sont pré-entraînés sur des milliards de pages de texte.
3. L’apprentissage par renforcement : apprendre par essais et récompenses
Un « agent » agit dans un environnement et reçoit des récompenses ou des pénalités. Il apprend la stratégie qui maximise ses gains à long terme, comme un enfant qui apprend à faire du vélo. C’est la méthode qui a permis à AlphaGo (Google DeepMind) de battre Lee Sedol en mars 2016, après avoir joué un très grand nombre de parties contre lui-même, et qui sert à entraîner des robots ou à affiner des assistants conversationnels.
Et pour ChatGPT ? Un apprentissage en plusieurs étapes
Un assistant conversationnel moderne n’apprend pas d’une seule façon. Il combine plusieurs méthodes, l’une après l’autre :
- Pré-entraînement auto-supervisé
Le modèle lit d’immenses volumes de textes (pages web, livres, code, encyclopédies) et apprend à prédire le mot — plus exactement le « token » — suivant. C’est l’étape la plus coûteuse.
- Réglage fin supervisé
Des humains rédigent des exemples de bonnes réponses à des consignes. Le modèle apprend à suivre des instructions plutôt qu’à simplement continuer un texte. OpenAI a présenté cette approche avec InstructGPT en 2022.
- Apprentissage par renforcement avec retour humain (RLHF)
Des évaluateurs humains classent plusieurs réponses du modèle de la meilleure à la moins bonne. Un second modèle, dit « modèle de récompense », apprend à prédire ces préférences, puis sert à affiner l’assistant par renforcement. Anthropic propose une variante, l’« IA constitutionnelle », où le modèle est guidé par une liste de principes écrits.
Pour le détail de ces étapes, voir comment fabrique-t-on une IA et comment fonctionne ChatGPT.
Les pièges de l’apprentissage
- Le surapprentissage (overfitting) : le modèle apprend « par cœur » ses exemples d’entraînement au lieu de généraliser. Il réussit les exercices connus et échoue sur les nouveaux. On le détecte en testant le modèle sur des données qu’il n’a jamais vues.
- Les biais des données : un modèle qui apprend sur des données déséquilibrées ou discriminatoires reproduit ces défauts (voir limites et risques).
- La qualité des étiquettes : si les exemples sont mal annotés, le modèle apprend des erreurs. « Garbage in, garbage out » (déchets en entrée, déchets en sortie) est un adage classique du domaine.
- Le coût énergétique : entraîner les plus grands modèles mobilise des milliers de processeurs pendant des semaines.
Questions fréquentes
Comment une IA apprend-elle concrètement ?
Elle répète une boucle : elle fait une prédiction, mesure son erreur avec une fonction de perte, puis ajuste légèrement ses paramètres pour réduire cette erreur. Après des milliards de répétitions sur des données, l’erreur devient faible.
Quelle est la différence entre apprentissage supervisé et non supervisé ?
En apprentissage supervisé, chaque exemple est accompagné de la bonne réponse (par exemple, une image étiquetée « chat »). En apprentissage non supervisé, il n’y a pas de bonne réponse fournie : le modèle cherche lui-même des structures dans les données.
Qu’est-ce que la rétropropagation ?
C’est l’algorithme qui calcule, pour chaque paramètre d’un réseau de neurones, comment il a contribué à l’erreur finale. Il permet de corriger efficacement des milliards de paramètres. Il a été popularisé en 1986 par Rumelhart, Hinton et Williams.
Qu’est-ce que le RLHF ?
Le RLHF (apprentissage par renforcement avec retour humain) est une étape où des humains classent les réponses d’une IA ; un modèle de récompense apprend ces préférences, puis sert à affiner l’assistant pour qu’il réponde de manière plus utile et plus sûre.
Une IA continue-t-elle d’apprendre après sa mise en service ?
Généralement non : un modèle déployé a des paramètres figés. Il peut garder le contexte d’une conversation, mais n’apprend pas à partir d’elle. Les éditeurs peuvent en revanche entraîner de nouvelles versions avec des données collectées, selon leur politique de confidentialité.
Sources et références
- Rumelhart, Hinton & Williams, « Learning representations by back-propagating errors », Nature, 1986
- Ouyang et al. (OpenAI), « Training language models to follow instructions with human feedback » (InstructGPT), 2022
- Wikipedia — Reinforcement learning from human feedback
- Bai et al. (Anthropic), « Constitutional AI: Harmlessness from AI Feedback », 2022
- Wikipedia — AlphaGo versus Lee Sedol