En bref
- L’IA générative crée du contenu nouveau : texte, image, voix, musique, vidéo, code. Elle apprend les régularités de millions d’exemples, puis génère des variations plausibles.
- Pour les images, la technique dominante est la diffusion : le modèle apprend à retirer du bruit, puis part d’un bruit aléatoire et le « débruite » progressivement jusqu’à obtenir une image guidée par votre description.
- Les contenus synthétiques (« deepfakes ») posent des questions de droit d’auteur, de consentement et de désinformation, que la réglementation européenne commence à encadrer.
Sur cette page
L’IA générative : produire plutôt que seulement classer
L’IA « classique » (dite discriminative) répond à des questions du type « cette image est-elle un chat ? ». L’IA générative fait l’inverse : « dessine-moi un chat astronaute ». Elle ne copie pas d’image existante : elle a appris les régularités statistiques de millions d’images (formes, textures, styles) et en produit de nouvelles qui leur ressemblent.
Pour le texte, ce principe est décrit dans comment fonctionne ChatGPT. Cet article se concentre sur l’image, le son et la vidéo.
Première génération : les GAN (2014)
En 2014, le chercheur Ian Goodfellow et ses collègues proposent les réseaux antagonistes génératifs (GAN). Le principe est un duel entre deux réseaux : un générateur qui fabrique des fausses images, et un discriminateur qui essaie de distinguer le vrai du faux. À force de s’affronter, le générateur devient capable de produire des images très réalistes.
Les GAN ont popularisé les visages synthétiques de personnes qui n’existent pas. Mais ils sont difficiles à entraîner et peu contrôlables à partir d’un texte. Ils ont été largement supplantés par les modèles de diffusion.
La diffusion : l’art de retirer du bruit
Les modèles de diffusion, popularisés par des travaux publiés vers 2020, sont à la base de DALL-E 2 (2022), Midjourney, Stable Diffusion (publié en août 2022 en accès libre) et de nombreux générateurs de vidéo. Leur idée est contre-intuitive :
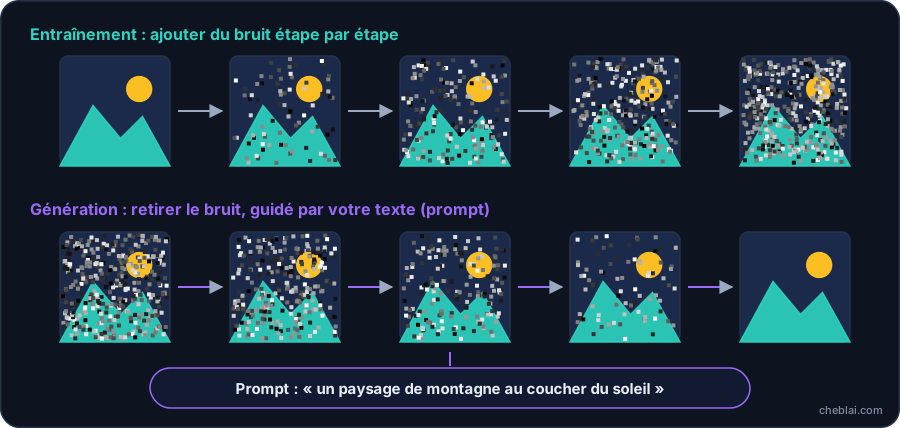
- Pendant l’entraînement
On prend une vraie image et on y ajoute progressivement du bruit (comme du grésillement de télévision) jusqu’à ce qu’elle devienne un bruit complètement aléatoire. Le modèle apprend à inverser chaque étape : retirer un peu de bruit.
- Quand vous générez
Le modèle part d’un bruit aléatoire pur et le « débruite » étape par étape, en étant guidé par votre description textuelle (le prompt). Une image apparaît progressivement.
- Le lien avec le texte
Un second modèle transforme votre description en nombres pour orienter le débruitage. Les modèles de type CLIP, entraînés sur des millions de paires image-légende, apprennent à faire correspondre les mots et les images.
Chaque génération part d’un bruit différent, c’est pourquoi un même prompt donne un résultat différent à chaque essai.
Voix, musique, vidéo : les autres domaines
| Domaine | Comment ça marche (en bref) | Exemples d’outils |
|---|---|---|
| Image | Diffusion guidée par du texte | Midjourney, Stable Diffusion, Adobe Firefly, Leonardo AI |
| Voix (synthèse vocale) | Un modèle apprend les caractéristiques d’une voix (timbre, rythme, intonation) pour lire n’importe quel texte | ElevenLabs |
| Musique | Des modèles génèrent un signal audio à partir d’un texte décrivant le style et les paroles | Suno AI |
| Vidéo | Diffusion appliquée à une succession d’images, avec une cohérence dans le temps | Runway Gen-4 |
| Montage et sous-titres | Transcription automatique puis édition du texte | Descript |
Retrouvez ces outils et leurs alternatives dans l’annuaire d’outils IA.
Limites techniques de l’image et de la vidéo générées
- Détails incohérents : mains, texte écrit, reflets ou symétries sont des points faibles classiques, même si les modèles récents s’améliorent vite.
- Cohérence dans le temps : en vidéo, garder le même visage, le même décor et la même physique sur toute la durée reste difficile.
- Contrôle limité : obtenir exactement l’image imaginée demande souvent de nombreux essais et de la précision dans le prompt.
- Biais : un modèle reproduit les stéréotypes présents dans ses données d’entraînement (par exemple, associer certains métiers à un genre).
Droit d’auteur, consentement et deepfakes
L’IA générative soulève des questions juridiques et éthiques majeures, encore en cours de clarification :
- Droit d’auteur : les modèles ont été entraînés sur d’immenses collections d’images et de textes, souvent protégés. Plusieurs procès sont en cours, par exemple de Getty Images contre Stability AI (2023) ou du New York Times contre OpenAI (décembre 2023). Les règles varient selon les pays et évoluent.
- Droit à l’image et consentement : cloner la voix ou le visage d’une personne sans son accord pose un problème légal et éthique majeur.
- Désinformation : les deepfakes (fausses vidéos ou voix réalistes) peuvent servir à tromper, à usurper une identité ou à harceler.
- Transparence : le règlement européen sur l’IA impose d’informer l’utilisateur qu’il interagit avec une IA et d’identifier les contenus synthétiques, notamment les deepfakes ; ces obligations de transparence s’appliquent depuis le 2 août 2026, avec un délai de grâce jusqu’au 2 décembre 2026 pour le marquage des contenus produits par des systèmes déjà sur le marché (voir limites, risques et régulation).
Questions fréquentes
Comment une IA crée-t-elle une image ?
La plupart des générateurs actuels utilisent un modèle de diffusion : il part d’un bruit aléatoire et le débruite progressivement, étape par étape, en étant guidé par votre description textuelle, jusqu’à obtenir une image cohérente.
Une image générée par IA copie-t-elle des images existantes ?
Le modèle n’assemble pas de morceaux d’images stockés : il génère des pixels à partir de régularités apprises. Il peut toutefois reproduire des styles ou, rarement, des éléments très proches de ses données d’entraînement, ce qui alimente les débats juridiques sur le droit d’auteur.
Quelle est la différence entre un GAN et un modèle de diffusion ?
Un GAN oppose deux réseaux (un générateur et un discriminateur) dans un duel. Un modèle de diffusion apprend à retirer du bruit et génère en le débruitant progressivement. La diffusion est aujourd’hui plus stable, plus contrôlable et domine la génération d’images.
Peut-on utiliser commercialement une image générée par IA ?
Cela dépend de l’outil (ses conditions d’utilisation) et du pays (statut juridique des œuvres générées par IA). Lisez les conditions de la plateforme, et évitez toute ressemblance avec des œuvres, marques ou personnes protégées.
Qu’est-ce qu’un deepfake ?
Un deepfake est un contenu (vidéo, image ou voix) généré ou modifié par IA pour imiter de façon réaliste une personne réelle. Il peut servir à la création, mais aussi à la désinformation ou à l’usurpation d’identité.