En bref
- Une IA moderne est un immense réseau de petites unités de calcul, les « neurones artificiels », reliées entre elles par des nombres appelés poids ou paramètres.
- Chaque neurone additionne des signaux reçus, les pondère, puis décide de transmettre ou non un signal. Empilées sur des dizaines de couches, ces opérations simples permettent de reconnaître des images ou de produire du langage.
- Tout le « savoir » de l’IA est stocké dans ses paramètres : GPT-3 en compte 175 milliards. Ce ne sont pas des faits rangés en mémoire, mais des réglages numériques.
Sur cette page
L’idée de base : des règles déduites, pas écrites
Imaginez que vous deviez écrire un programme qui reconnaît un chat sur une photo. Écrire à la main toutes les règles (« deux oreilles pointues, des moustaches… ») est quasiment impossible : les chats ont toutes les formes, couleurs et postures. L’IA moderne contourne le problème : on lui montre des millions de photos étiquetées « chat » ou « pas chat », et elle ajuste elle-même ses réglages internes jusqu’à réussir à les distinguer.
Ce mécanisme d’ajustement s’appelle l’entraînement (voir comment une IA apprend). Cet article explique plutôt ce que l’on obtient à la fin : le modèle lui-même, et ce qui se passe quand on l’utilise.
Le neurone artificiel : une petite calculatrice
Le neurone artificiel s’inspire (de très loin) des neurones du cerveau. Le premier modèle mathématique date de 1943 (Warren McCulloch et Walter Pitts). Voici ce qu’il fait :
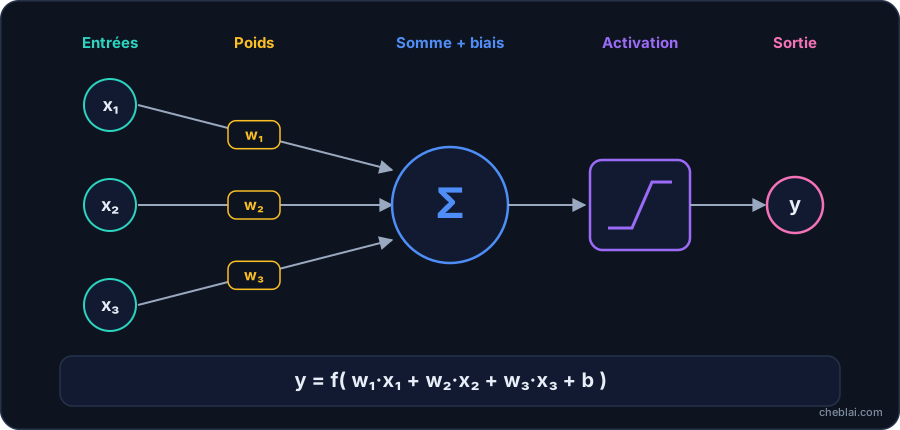
- Il reçoit des entrées
Ce sont des nombres : par exemple la luminosité de pixels d’une image, ou la représentation numérique d’un mot.
- Il pondère chaque entrée
Chaque entrée est multipliée par un poids, qui indique son importance. Un poids élevé signifie « ce signal compte beaucoup » ; un poids négatif signifie « ce signal pousse dans le sens inverse ».
- Il additionne le tout
Il fait la somme des entrées pondérées, puis ajoute un petit décalage appelé biais.
- Il applique une fonction d’activation
Une règle simple décide de la force du signal transmis (par exemple : « ne transmets rien si la somme est négative »). Sans cette étape, empiler des neurones ne servirait à rien : le résultat resterait une simple opération linéaire.
Le réseau de neurones : des couches qui extraient du sens
Les neurones sont organisés en couches. La première reçoit les données brutes, la dernière donne le résultat, et les couches intermédiaires (dites « cachées ») transforment progressivement l’information. C’est ce qu’on appelle le deep learning, ou apprentissage profond : « profond » désigne le nombre de couches.
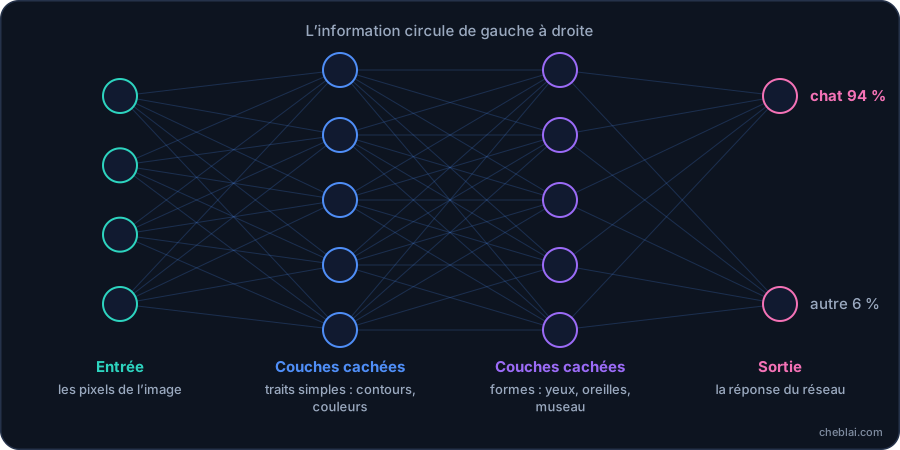
Dans un réseau qui reconnaît des images, on observe en général une progression : les premières couches détectent des traits simples (contours, taches de couleur), les suivantes des formes (yeux, oreilles, roues), les dernières des objets entiers (visage, chat, voiture). Personne n’a programmé cette hiérarchie : elle émerge de l’entraînement.
Les paramètres : là où se trouve le « savoir » du modèle
L’ensemble des poids et des biais d’un modèle s’appelle ses paramètres. Ce sont les « boutons de réglage » que l’entraînement ajuste. Un modèle ne contient ni base de données de faits, ni phrases mémorisées sous forme lisible : ses connaissances sont réparties dans des milliards de nombres.
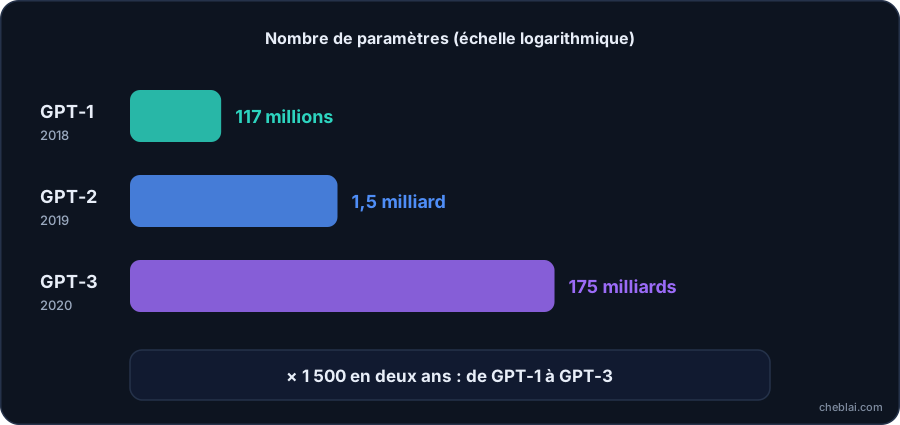
Plus un modèle a de paramètres, plus il peut capturer de nuances, à condition de disposer de suffisamment de données et de puissance de calcul pour l’entraîner. Mais plus grand n’est pas toujours mieux : des modèles plus petits mais mieux entraînés peuvent surpasser de plus grands modèles, et ils coûtent moins cher à utiliser.
Entraînement et inférence : deux moments à ne pas confondre
La vie d’un modèle d’IA se divise en deux phases très différentes.
| Entraînement | Inférence (utilisation) | |
|---|---|---|
| Que se passe-t-il ? | Le modèle ajuste ses paramètres à partir de données | Le modèle, figé, produit une réponse à votre demande |
| Quand ? | Une fois (ou par grandes phases), avant la mise en service | À chaque requête d’un utilisateur |
| Durée | Des semaines ou des mois pour un grand modèle | Quelques secondes |
| Coût | Très élevé : des milliers de GPU et des millions de dollars pour les plus grands modèles | Faible par requête, mais énorme au total avec des millions d’utilisateurs |
| Le modèle apprend-il de ma conversation ? | Oui, mais c’est justement ce qui se passe à cette étape | Non : en conversation, il ne modifie pas ses paramètres (même s’il peut garder le contexte de la discussion) |
Tous les réseaux de neurones ne se ressemblent pas
On adapte l’architecture du réseau au type de données :
- Réseaux convolutifs (CNN) : spécialisés dans l’image. Popularisés par Yann LeCun dès les années 1990, ils ont connu leur heure de gloire avec AlexNet en 2012.
- Réseaux récurrents (RNN, LSTM) : conçus pour les suites (texte, son), en lisant mot après mot. Ils ont dominé le langage jusqu’en 2017.
- Transformers : introduits en 2017, ils lisent une séquence entière en parallèle grâce à un mécanisme d’attention. Ils sont à la base de ChatGPT, Claude, Gemini, et aussi de nombreux modèles d’image et d’audio (voir comment fonctionne ChatGPT).
- Modèles de diffusion : spécialisés dans la génération d’images, de vidéo et de son (voir IA générative).
Ce qu’il faut garder en tête
- Une IA ne « sait » pas : elle calcule. Sa réponse est le résultat de millions d’opérations numériques, pas d’un raisonnement conscient.
- On ne comprend pas tout. Les réseaux de neurones sont souvent des « boîtes noires » : on sait comment les entraîner, mais il est difficile d’expliquer précisément pourquoi ils donnent telle réponse. L’interprétabilité est un domaine de recherche actif.
- Un modèle reflète ses données. S’il a été entraîné sur des données biaisées ou incomplètes, ses réponses le seront aussi (voir limites et risques).
Questions fréquentes
Comment fonctionne un réseau de neurones en termes simples ?
Un réseau de neurones est une suite de couches de petites unités de calcul. Chaque unité additionne des signaux pondérés et transmet un résultat à la couche suivante. En ajustant les poids à partir d’exemples, le réseau apprend à reconnaître des motifs : un visage, un mot, un son.
Qu’est-ce qu’un paramètre dans une IA ?
Un paramètre est un nombre (un poids ou un biais) à l’intérieur du modèle, ajusté pendant l’entraînement. Le savoir d’une IA est réparti dans ses paramètres : GPT-3 en compte 175 milliards.
Quelle est la différence entre entraînement et inférence ?
L’entraînement est la phase, longue et coûteuse, où le modèle ajuste ses paramètres à partir de données. L’inférence est l’utilisation du modèle déjà entraîné pour répondre à une demande.
Une IA stocke-t-elle des informations comme une base de données ?
Non. Un modèle ne contient pas de fichiers consultables : ses connaissances sont encodées sous forme de nombres répartis dans ses paramètres, ce qui explique qu’il puisse mélanger ou inventer des détails.
Pourquoi parle-t-on de « boîte noire » ?
Parce que, même si l’on connaît l’architecture et les données d’un réseau de neurones, il est très difficile d’expliquer pourquoi il produit exactement telle réponse dans tel cas. L’interprétabilité des modèles est un champ de recherche actif.